
Главная мысль
Измеряйте задержки и ошибки, которые видит пользователь, затем переходите к соответствующим трассировкам, журналам и метрикам зависимостей за тот же период. Инструмент сам по себе не объясняет проблему: нужны корректная настройка сбора телеметрии и контекст.
Мониторинг и наблюдаемость дополняют друг друга
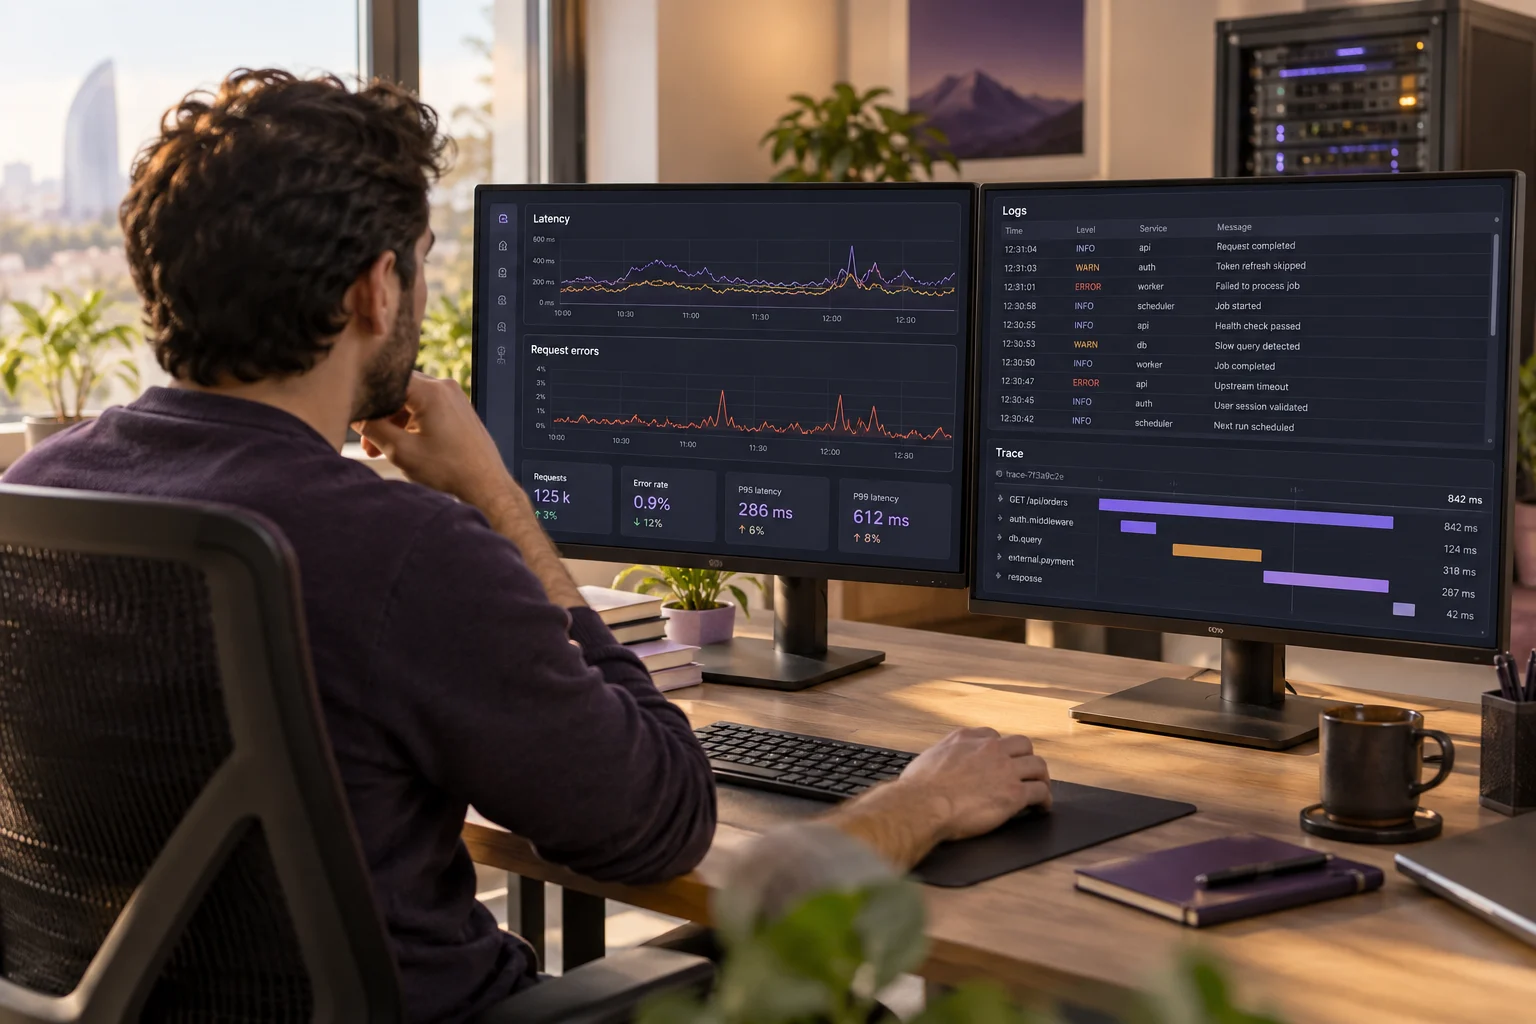
Мониторинг отслеживает выбранные показатели и условия, например рост ошибок или недоступность сервиса, и сообщает команде о проблемах. Наблюдаемость — способность понять внутреннее состояние системы по создаваемой ею телеметрии: журналы описывают события, метрики — измерения во времени, трассировки — путь запроса через компоненты. Мониторинг помогает обнаружить отклонение; связанные данные позволяют исследовать, почему запрос замедлился. Это взаимосвязанные возможности, а не строго разделённые классы инструментов. Для поиска причины нужны подходящие источники, поля и контекст.
| Сигнал | Основной вопрос | Пример |
|---|---|---|
| Метрика | Сколько, когда и как меняется? | Число запросов, доля ошибок, задержка. |
| Журнал | Какое событие произошло и в каком контексте? | Тайм-аут зависимости и код ошибки. |
| Трассировка | Через какие компоненты прошёл запрос? | Операции API → сервиса → базы данных (span). |
В APM проследите запрос до зависимости
Application Performance Monitoring (APM) отслеживает время ответа, ошибки, объём запросов и использование ресурсов приложения и его зависимостей. Если запрос медленный, проследите путь от API к сервисам, базе данных, кешу и очереди сообщений. Отображение времени выпуска, версии и затронутого региона рядом с метриками помогает найти начало регрессии. Агент или инструменты, добавляющие сбор данных в байткод, могут создавать нагрузку и собирать чувствительный контекст; сначала проверьте объём и поля на критичном приложении.
Подтвердите влияние
Измерьте задержку, ошибки и масштаб влияния на реальные запросы.
Проследите путь
Свяжите участки обработки запроса (span) в API, сервисах и зависимостях по идентификатору трассировки (trace ID).
Сравните изменения
Проверьте версию, конфигурацию и нагрузку; подтвердите проблему другим сигналом.
Связывайте журналы с трассировками и метриками
В распределённом приложении идентификаторы trace/span и контекст сервиса помогают связать запись журнала с операциями в трассировке. Span описывает отдельную операцию, включая её начало, завершение, статус и выбранные безопасные атрибуты; она может выполняться и внутри одного сервиса. Хранение всех трассировок при большом объёме увеличивает расходы. Выборка сокращает объём, но может потерять редкие запросы и ошибки. Проверьте это на характерной нагрузке; выбор по результатам завершённых операций помогает приоритизировать ошибки, но не восстанавливает данные, отброшенные раньше. OpenTelemetry предоставляет общие модели сигналов и средства передачи через коллектор.
Журнал
Текст и поля отдельного события.
Метрика
Числовые измерения во времени: счётчик, распределение или текущее значение (gauge).
Трассировка
Записанные операции запроса и их длительность.
Свяжите обратную связь с релизами DevOps
Когда мониторинг отслеживает одинаковые основные показатели на этапах разработки, тестирования и эксплуатации, проще сравнить влияние выпуска. Используйте единое время и названия сервисов на панелях; каждое оповещение должно указывать ответственного и следующий шаг проверки. Пороги CPU и памяти сами по себе не отражают влияние на пользователя: свяжите задержки, ошибки и доступность с целями сервиса. Prometheus собирает метрики и может формировать оповещения по правилам, а Grafana строит панели и визуализации по подключённым источникам данных.
RUM и синтетический мониторинг закрывают разные пробелы
Real User Monitoring (RUM) собирает показатели производительности в реальных сессиях поддерживаемых браузеров; синтетический мониторинг по расписанию повторяет заранее заданные запросы и пользовательские сценарии. RUM может показать различия по устройствам, браузерам, сетям и регионам, но при малом трафике выборка пути может быть ограниченной. Синтетическая проверка тестирует критические сценарии входа или оплаты независимо от трафика, но не полностью отражает реальные устройства и сети. Используйте оба подхода и заранее проверьте, какие данные собирает, хранит и передаёт скрипт RUM.
| Подход | Преимущество | Ограничение |
|---|---|---|
| RUM | Опыт реальных устройств и сетей. | Зависит от трафика и охвата скрипта. |
| Синтетический | Повторяемый сценарий и проверка по расписанию. | Не полностью отражает среду реального пользователя. |
Интерпретируйте показатели реальных пользователей
Google Core Web Vitals измеряют загрузку, интерактивность и визуальную стабильность реального пользовательского опыта: LCP — время отрисовки крупнейшего изображения или текстового блока в видимой области, INP — отклик на взаимодействие, CLS — неожиданные сдвиги макета. В RUM группируйте показатели по региону, устройству и типу страницы: одно среднее может скрыть проблемную группу. Дополнительные значения вроде TTFB и FCP помогают исследовать путь от сервера до браузера.